O robots.txt indica aos crawlers de IA quais partes do site podem ser acessadas; ele segue a norma RFC 9309, aceita apenas regras simples e não garante segurança nem impede o uso de conteúdo já coletado.
O essencial em cinco pontos
- O robots.txt é lido antes de qualquer rastreamento e aceita apenas diretivas definidas na norma RFC 9309.
- É possível bloquear crawlers de IA usando o nome de agente correto, mas a regra não impede que o conteúdo já coletado seja usado para treinamento.
- Caractere internacional ou emojis precisam ser codificados em percent‑encoding; caso contrário a regra pode ser ignorada por alguns bots.
- Robots.txt não é mecanismo de segurança: ele apenas solicita que crawlers obedientes respeitem as restrições.
- Empresas B2B devem validar sintaxe, testar URLs e combinar robots.txt com meta‑tags no‑index para garantir que páginas sensíveis não apareçam nos resultados de IA.
Por que o robots.txt ainda importa na era da IA
Desde a primeira versão da Web, o arquivo robots.txt tem sido a primeira linha de comunicação entre um site e os rastreadores automáticos. Hoje, além dos buscadores tradicionais, surgiram crawlers dedicados ao treinamento de modelos de inteligência artificial. Esses bots também consultam o robots.txt antes de acessar qualquer recurso, o que torna o arquivo relevante para quem deseja controlar a exposição de conteúdo a sistemas como o Gemini ou o ChatGPT.
A documentação oficial do Google explica que o robots.txt serve principalmente para gerenciar o tráfego de rastreamento e evitar sobrecarga de servidores, não para impedir que uma página apareça nos resultados de busca. Quando um URL está bloqueado, ele ainda pode aparecer nos resultados, porém sem descrição. Essa distinção é crucial para empresas B2B que precisam proteger informações estratégicas enquanto mantêm a visibilidade de páginas de produto.
Regras básicas que o Google aceita no robots.txt
O Google segue estritamente a norma RFC 9309, que define quatro diretivas reconhecidas: User-agent, Allow, Disallow e Sitemap. Qualquer outra linha é ignorada silenciosamente. Por isso, ao criar regras para crawlers de IA, é imprescindível usar exatamente esses termos, sem variações ou formatação criativa.
Um exemplo clássico, presente na documentação oficial, mostra como permitir que o Googlebot acesse a pasta “includes” enquanto bloqueia o mesmo caminho para todos os demais bots. Essa granularidade permite que empresas liberem recursos necessários para renderização (como CSS e JavaScript) sem abrir todo o site para indexação indiscriminada.
Como especificar regras para crawlers de IA
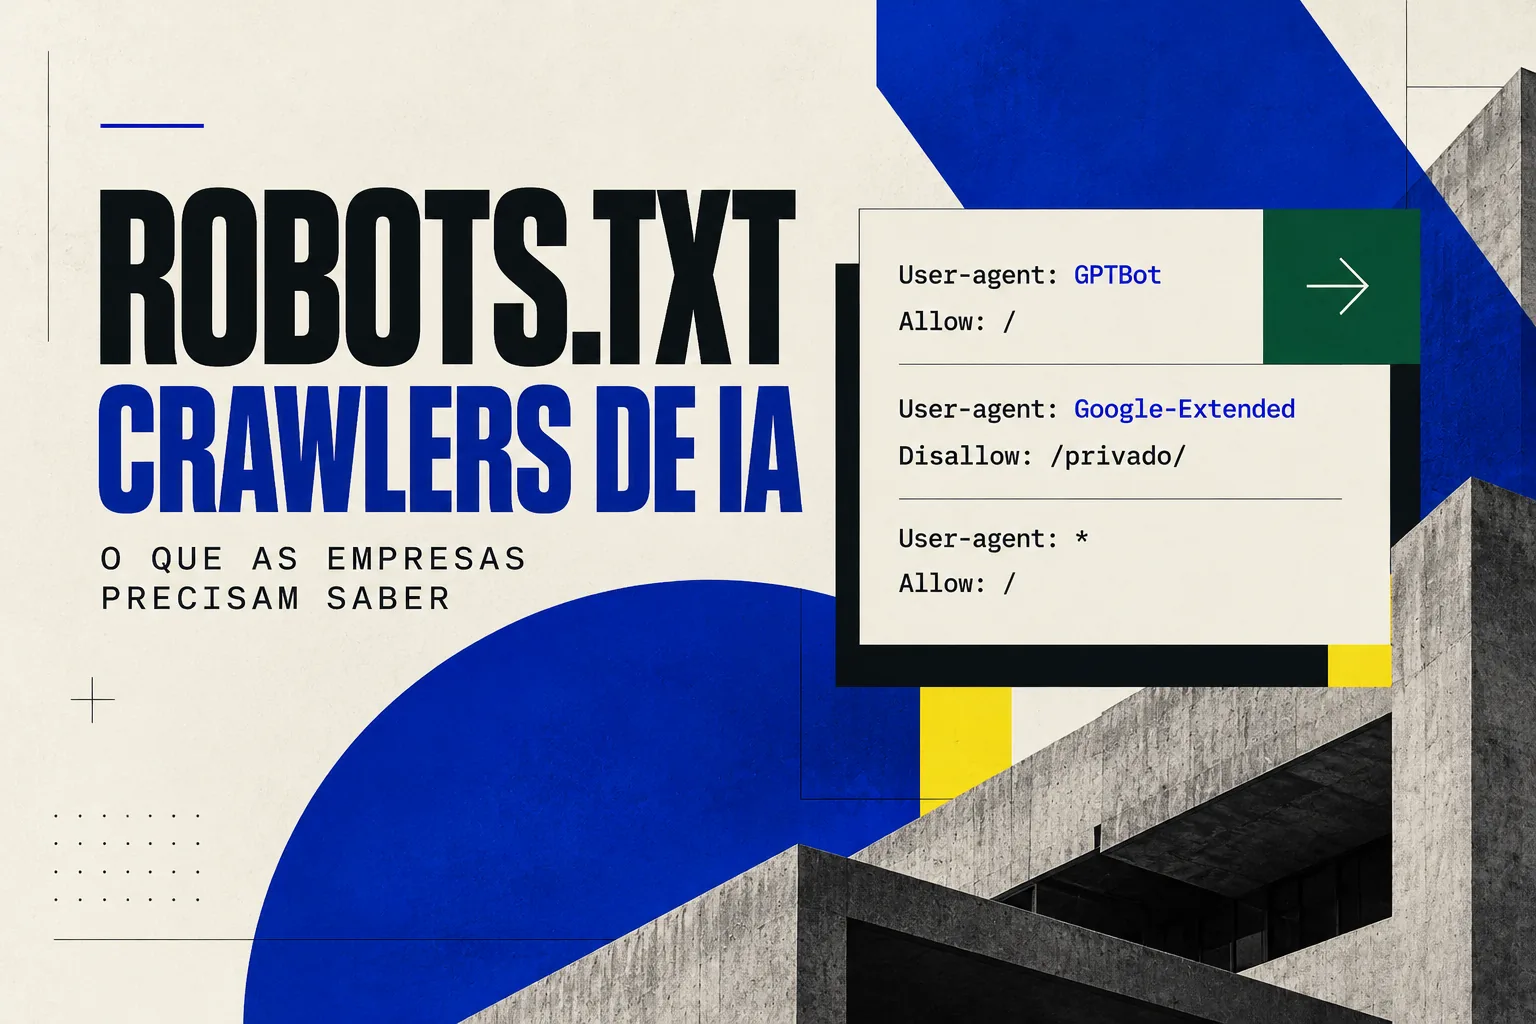
Para direcionar um crawler de IA, o nome do agente deve ser exatamente o token reconhecido pelo bot. Por exemplo, se o agente for “Google-Extended”, a linha deve ser "User-agent: Google-Extended" seguida da diretiva Disallow ou Allow desejada. O vídeo da série Non‑Canonical Cabinet, citado pelo Search Engine Roundtable, reforça que usar o nome correto evita que a regra seja ignorada.
Além do nome, a codificação de caracteres não‑ASCII é obrigatória. Quando se deseja bloquear URLs que contenham emojis ou caracteres acentuados, deve‑se usar percent‑encoding (por exemplo, %F0%9F%90%9B para o emoji de galinha). Caso contrário, diferentes implementações de crawlers podem interpretar a regra de forma distinta, resultando em acesso não autorizado.
Impacto prático para empresas B2B no Brasil
Para uma empresa B2B, a principal preocupação costuma ser a exposição de documentos internos, catálogos de preços ou APIs que não devem ser consumidas por modelos de IA. Ao combinar robots.txt com a meta‑tag noindex, a empresa garante que a página não seja indexada nem exibida em respostas de IA, reduzindo o risco de vazamento de informações sensíveis.
Entretanto, a evidência das fontes deixa claro que bloquear um crawler de IA não impede que o conteúdo já coletado seja usado em treinamento futuro. O Google diferencia controle de rastreamento (robots.txt) de políticas de treinamento, que são definidas em acordos separados. Assim, a prática recomendada é usar robots.txt como camada de mitigação, mas não como solução definitiva de privacidade.
Limitações conhecidas e como validar suas regras
A principal limitação do robots.txt é que ele não é um mecanismo de segurança. Bots maliciosos podem simplesmente ignorar o arquivo. Além disso, a especificação não cobre políticas de treinamento de IA; portanto, mesmo que um crawler seja bloqueado, o Google pode já ter obtido cópias de páginas via outros meios (por exemplo, links externos).
Para garantir que as regras estejam corretas, o Google recomenda validar a sintaxe usando ferramentas de teste de URL e observar o comportamento real dos crawlers nos logs do servidor. A prática de “não assumir que a regra funciona porque parece correta” foi enfatizada no vídeo da série Non‑Canonical Cabinet, que alerta para inconsistências de codificação e para a necessidade de testar cada padrão de URL.
Este artigo também gera um alerta sobre a importância de se ter profissionais ou empresas especializadas nas boas práticas de SEO e GEO atuando na manutenção dos sites corporativos, a fim de preservar a segurança além de obter os melhores resultados. - José Jarbas
Fontes e evidências
As fontes abaixo sustentam as afirmações centrais desta análise. O acesso foi verificado na data indicada.
- Google On robots.txt Rules For AI Crawlers, Emojis, International URLs & MoreSearch Engine Roundtable · veículo especializado · acesso em 21 de outubro de 2026
- Robots.txt Introduction and Guide | Google Search Central | Documentation | Google for DevelopersGoogleGoogledevelopers.google.com · fonte oficial · acesso em 21 de outubro de 2026
- How Google Interprets the robots.txt Specification | Google Crawling Infrastructure | Crawling infrastructure | Google for Developersdevelopers.google.com · fonte oficial · acesso em 21 de outubro de 2026
Perguntas frequentes
O robots.txt impede que o Google use meu conteúdo para treinar IA?
Não. O robots.txt apenas solicita que crawlers obedientes não acessem determinadas URLs. O uso de conteúdo já coletado para treinamento é regulado por políticas separadas, não pelo arquivo.
Como bloquear um crawler que usa emoji no nome do agente?
É preciso usar percent‑encoding para o emoji no campo User-agent, por exemplo "User-agent: %F0%9F%90%9B". Sem a codificação, a regra pode ser ignorada.
Posso usar o robots.txt para proteger páginas de login ou áreas restritas?
Não. O robots.txt não oferece segurança; ele apenas orienta crawlers bem‑comportados. Para proteger áreas sensíveis, use autenticação, senhas ou a meta‑tag noindex.
Qual a diferença entre Disallow e a meta‑tag noindex?
Disallow impede que o crawler acesse a URL, mas a página ainda pode aparecer nos resultados sem descrição. A meta‑tag noindex indica ao motor de busca que a página não deve ser exibida nos resultados, mesmo que seja rastreada.
Como testar se minhas regras de robots.txt estão funcionando?
Use a ferramenta de teste de URL do Google Search Console, verifique os logs do servidor para confirmar que o crawler respeita as diretivas e valide a sintaxe segundo a RFC 9309.
Este conteúdo identifica fontes, distingue fatos de análise e passa pela curadoria de José Jarbas, fundador da Ex.id. Conheça a metodologia.